Le résumé que ChatGPT écrit juste avant de bloquer une conversation a l’air complet : nom du projet, dernière action effectuée, parfois même un numéro de commit. Pourtant, ce commit cité peut déjà avoir été remplacé sur la branche distante. La limite de contexte efface ce que le modèle garde en mémoire de l’échange ; l’état réel de votre dépôt, lui, reste inchangé. Pour transmettre une passation fiable à un nouveau chat, comparez le commit local au commit distant sur la branche concernée avant de faire confiance au résumé. Ce guide donne les commandes exactes, la taille de fenêtre par offre, la fonction Branch in a new chat et une checklist de passation, avec une variante utilisable en dehors d’un dépôt Git.
3 repères suffisent avant d’aller plus loin. La fenêtre se ferme vers 27 000 jetons sur Free, 54 000 sur Go et sur Plus, autant sur Business (256 000 avec le modèle de raisonnement Thinking) et jusqu’à 400 000 sur Pro. Le message qui signale le blocage s’affiche en anglais : « You’ve reached the maximum length for this conversation ». Pour repartir sans perdre le fil, la fonction «Branch in a new chat», accessible sous une réponse déjà donnée, ouvre un nouveau chat avec une fenêtre de contexte remise à zéro.
Le message qui bloque la conversation
ChatGPT affiche « You’ve reached the maximum length for this conversation », soit « vous avez atteint la longueur maximale pour cette conversation », quand la fenêtre de contexte du fil est pleine. Ce message diffère d’un quota de messages, qui borne le nombre de requêtes sur une période plutôt que le volume de texte accumulé dans un seul fil. Rien ne prévient avant son apparition : le signalement GitHub détaillé plus bas réclame justement l’ajout d’un avertissement proactif, preuve qu’aucun ne s’affiche aujourd’hui.
Les tailles de fenêtre par offre
Le modèle instantané de ChatGPT va de 27 000 jetons sur l’offre Free à 128 000 sur Pro, en passant par 54 000 sur Go et Plus, d’après la page tarifs officielle de ChatGPT consultée le 25 septembre 2026. La taille de la fenêtre dépend à la fois de l’offre et du modèle choisi : le forfait payé fixe un premier plafond, le modèle actif fixe l’autre.
OpenAI y explique, en anglais, que ChatGPT gère une fenêtre de contexte partagée pour comprendre la demande, suivre la conversation, récupérer des informations pertinentes et générer des réponses.
Le modèle de raisonnement, nommé « Thinking » dans l’interface et propulsé par la famille GPT-6 depuis le déploiement des modèles «Sol» et «Luna» le 22 septembre 2026, monte à 256 000 jetons sur Go et sur Plus, autant sur Business. Il atteint 400 000 jetons sur Pro, presque 3 fois la fenêtre de Plus.
| Offre | Fenêtre instantanée | Fenêtre de raisonnement |
|---|---|---|
| Free | 27 000 jetons | non disponible |
| Go | 54 000 jetons | 256 000 jetons |
| Plus | 54 000 jetons | 256 000 jetons |
| Business | 54 000 jetons | 256 000 jetons |
| Pro | 128 000 jetons | 400 000 jetons |
Ce comptage vient de la documentation API sur la gestion du contexte, d’après OpenAI, qui additionne les jetons de sortie et les jetons de raisonnement du modèle Thinking dans le total retenu. L’interface ChatGPT web reste silencieuse sur ce détail : le chiffre que vous voyez consommé à l’écran peut donc s’écarter légèrement de celui calculé côté API pour la même conversation.
Un jeton représente environ 75 % d’un mot en anglais, un peu moins en français à cause des mots composés et des accents. Une fenêtre de 54 000 jetons couvre donc grossièrement 35 000 à 40 000 mots d’échange, fichiers joints compris, contre 90 000 à 95 000 mots pour les 128 000 jetons de Pro : plusieurs heures de conversation dense avant d’atteindre le message de blocage. Passer de Plus à Pro sans changer de modèle laisse la fenêtre instantanée identique ; c’est le choix du modèle de raisonnement qui fait la différence de capacité, indépendamment du forfait.
Le témoignage qui a lancé l’alerte
Un utilisateur a documenté, dans un témoignage publié sur r/OpenAI le 24 septembre 2026, un résumé de passation citant un commit antérieur à celui réellement poussé sur GitHub. Une tâche avait fait avancer l’état du dépôt ; le document de transfert généré par ChatGPT Web reprenait pourtant un commit plus ancien. Le HEAD distant a été vérifié à plusieurs reprises dans la conversation suivante, d’après Reddit ; le résumé, lui, est resté identique.
Le post décrit un incident vécu, documenté par des captures d’écran ; aucune preuve publique ne confirme pour autant que l’interface a supprimé un message du contexte. Un autre sujet, ouvert le 17 août 2026 sur la communauté OpenAI et qui a reçu 3 réponses, réclame un « one-click project handoff system » et décrit une continuité difficile après la limite, avec chaque fois un mécanisme différent en cause. Un signalement GitHub, détaillé plus bas, décrit un symptôme voisin sur ChatGPT Work.
Pourquoi le résumé automatique peut se tromper
Le résumé se trompe parce qu’il retient les grandes lignes de la conversation ; le dernier état technique exact se vérifie ailleurs. Quand un fil approche sa fenêtre, ChatGPT compresse les échanges les plus anciens en un résumé pour libérer de la place aux nouveaux messages, un mécanisme de fenêtre glissante décrit par la documentation API d’OpenAI sur la gestion du contexte. Un résumé rédigé un tour avant le blocage peut figer une version intermédiaire du projet plutôt que la version finale, surtout si plusieurs actions se sont enchaînées juste avant la coupure.
Ce mécanisme s’active automatiquement selon le remplissage de la fenêtre, de façon identique sur toutes les offres et non paramétrable depuis les réglages du compte. La parade la plus fiable reste de comparer le résumé à une source de vérité externe, Git en tête pour un projet versionné.
Brancher un nouveau chat au bon endroit
Le point de branchement décide de tout : choisissez une réponse antérieure à la dernière, celle où la conversation répondait encore normalement. Le chemin «Trois points» puis «Branch in a new chat», sous une réponse ChatGPT, ouvre un nouveau fil qui conserve l’historique jusqu’au point choisi, jetons consommés remis à 0. La fonction est disponible sur le web à tous les comptes connectés, Free compris ; elle reste absente de l’application mobile ChatGPT.
Le point de départ compte plus que la fonction elle-même. Brancher depuis la réponse qui a déclenché l’erreur reproduit immédiatement le même blocage, puisque le fil hérite d’une fenêtre déjà pleine à ce moment de la conversation. Remontez de plusieurs échanges, quitte à perdre les derniers superflus, jusqu’à retrouver ce point de réponse normale.
Vérifier le dépôt avant de transmettre le résumé
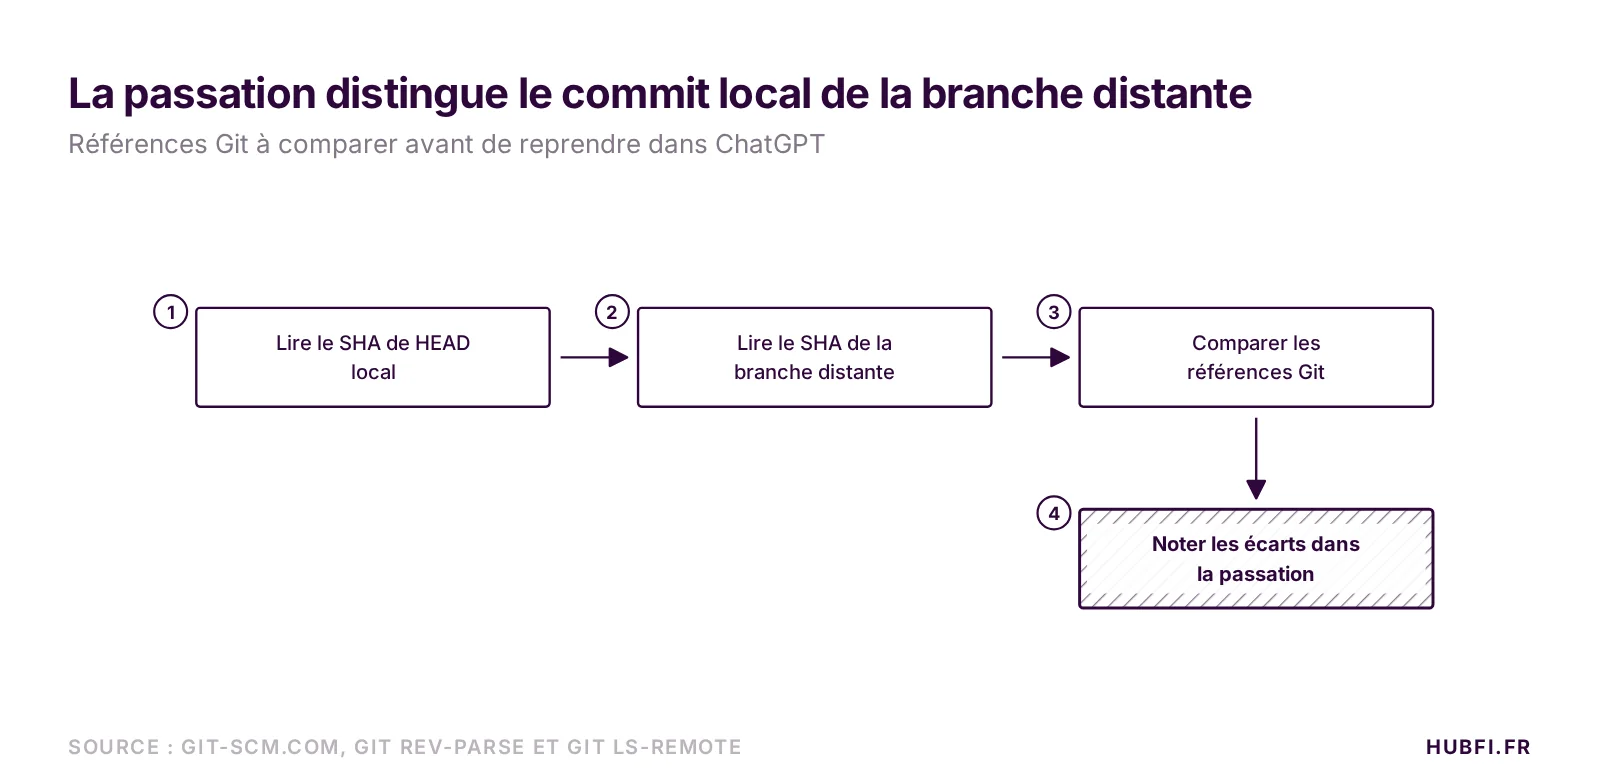
Comparez le SHA du commit local à celui de la branche distante avant de demander la synthèse finale au fil qui bloque : cette vérification prime sur le dernier message de ChatGPT. Ouvrez le dépôt tant que la conversation répond encore. Ces 4 commandes lisent la branche active puis comparent la référence locale à la référence distante, en lecture seule :
git branch --show-current
git rev-parse HEAD
git status --short --branch
git ls-remote --exit-code origin "refs/heads/$(git branch --show-current)"
La documentation de rev-parse explique comment cette commande résout HEAD en identifiant de commit, un SHA qui tient sur 40 caractères hexadécimaux dans sa forme complète, souvent abrégé à 7 caractères dans les journaux de commit. La documentation de status précise la lecture de l’arbre de travail. Celle de ls-remote décrit la lecture des références distantes. Sur le dépôt public git/git, une vérification d’une branche inexistante avec cette dernière commande ne renvoie aucun SHA et se termine avec le code de sortie 2, conformément à sa documentation.
Cette méthode reste directe pour un projet déjà suivi par Git ; en dehors d’un dépôt versionné, réunir une preuve équivalente prend quelques minutes de plus, le temps de rassembler les traces disponibles ailleurs. Un écart entre la référence locale et la référence distante n’est pas forcément une erreur : des changements restent peut-être à pousser ou une autre personne a fait avancer la branche pendant l’échange. Comparez les 2 valeurs à la tâche en cours avant de reprendre un travail qui dépend d’une référence précise.
Ce contrôle croisé entre résumé et source réelle est le même réflexe que la vérification des faits avant publication, celui qui limite une hallucination du modèle.
Un workflow de prompt chaining qui note un état explicite à chaque étape produit déjà ce journal, plus fiable qu’un résumé reconstitué après coup : la passation se relit au lieu de se reconstruire. Sans un tel dispositif, un fichier daté suffit : relu en 30 secondes, il évite de reconstituer tous les échanges.
La checklist de passation, avec ou hors dépôt Git
5 champs suffisent à rendre une passation vérifiable. Notez-les dans un fichier conservé avec le projet, plutôt que dans le seul fil ChatGPT :
- Branche active : nom exact de la branche en cours, du type «main» ou «feature/passation».
- Référence locale : le SHA complet du commit courant.
- Référence distante : le SHA de la branche sur le dépôt distant.
- Dernier résultat confirmé : l’action dont une sortie d’outil atteste le succès, par exemple un statut «200 OK» ou un identifiant d’objet créé.
- Prochaine action autorisée : ce que la personne suivante peut lancer en confiance, par exemple «reprendre le déploiement» ou «relire la PR», le reste de la vérification déjà fait.
Un growth ops qui pilote une campagne depuis «Notion» ou «Trello» n’a pas de commit à comparer : la même logique s’applique tout de même, les 3 premiers champs devenant le lien vers la carte ou la tâche, l’identifiant de la campagne dans l’outil d’envoi (Mailjet, HubSpot ou Brevo) et l’horodatage du dernier statut vu à l’écran.
Une capture d’écran datée de ce statut, jointe au fichier de passation, vaut ce que vaut un SHA pour un dépôt : une preuve prise en dehors du fil, recontrôlable sans redemander l’historique à qui a laissé la conversation bloquée. Chaque champ pointe vers une preuve extérieure au fil, jamais vers une phrase générée par le modèle seule.
Le prompt qui sépare le vérifié du déduit
Le prompt suivant distingue, dans la réponse de ChatGPT, les faits établis par une sortie d’outil des déductions sans preuve du modèle ; il s’utilise tant que le fil accepte encore un tour, avant la synthèse finale. Chaque commande de ce guide s’exécute et se vérifie ; le témoignage Reddit cité plus haut, daté du 24 septembre 2026, reste public :
Prépare la passation de ce projet à partir des informations disponibles.
Sépare l'état confirmé par une sortie d'outil de ce que le modèle
rapporte sans preuve. Signale à part toute action dont le résultat
reste inconnu.
Indique la branche, le commit local et le commit distant seulement si
une sortie récente les montre. Sinon, écris "à vérifier dans Git".
N'invente aucun identifiant, aucune commande exécutée ni aucun succès.
Le gabarit tient en 7 lignes, copiables telles quelles dans le fil qui bloque, y compris en mode «Thinking». Le document obtenu doit nommer le dernier résultat vérifié et, si une action a été lancée sur un service externe, le lien de l’objet créé. Comparez ensuite chaque champ aux valeurs relevées plus haut avant de coller la passation dans le nouveau chat.
Une action doublée coûte plus cher qu’une vérification
2 minutes de vérification coûtent moins cher qu’une action relancée en double : le signalement GitHub «openai/codex#41531», déposé le 29 août 2026, documente un incident de tool use sur ChatGPT Work avec des connecteurs externes actifs sur le compte, GitHub notamment. Un agent connecté avait déclenché la création d’une automatisation externe ; la conversation a atteint sa limite de longueur avant de renvoyer une confirmation visible de ce succès. Faute de reçu, la conversation de remplacement a recréé la même automatisation en double, avant qu’une vérification manuelle de l’état réel chez le prestataire ne retrouve l’automatisation d’origine. Ce rapport, qui renvoie vers 5 signalements connexes ouverts sur le même dépôt, décrit une prudence proche de celle du fil Reddit, appliquée cette fois à une action de connecteur plutôt qu’à un commit Git.
Pour une opération dont la répétition a un coût réel, le document de passation doit porter le nom du service concerné et le lien de l’objet réellement créé. Si seule la demande envoyée au modèle est disponible, écrivez « résultat inconnu » plutôt que « terminé » : quiconque reprend la main contrôlera le service avant de relancer quoi que ce soit.
Sur un CRM comme HubSpot, un contact importé 2 fois crée un doublon qu’il faut fusionner à la main ; le même risque existe pour une facture. Défusionner coûte une intervention manuelle, parfois avec l’aide du support de l’outil concerné.
Si la conversation refuse tout nouveau message
Quand le fil bloque toute nouvelle demande, partez de ce qui reste visible à l’écran et des traces conservées dans le dépôt ou l’outil de tâches. Vérifiez ensuite le service concerné avant de relancer une action qui pourrait créer un doublon.
OpenAI détaille, dans l’article « How do I export my ChatGPT history and data », un export des données accessible depuis Réglages > Contrôles des données > Exporter. La demande génère un lien de téléchargement envoyé par email, avec un délai annoncé jusqu’à 7 jours et un lien qui expire 24 heures après réception : cet export récupère un historique complet, sur un délai incompatible avec une passation immédiate. Sur les espaces Business ou Enterprise, la démarche passe par l’administrateur de l’espace plutôt que par cet export en libre-service.
Si vous pouvez comparer un tour perdu à des traces réelles, signalez le cas au support OpenAI en indiquant l’heure et le navigateur utilisé. Joignez ensuite les étapes de reproduction, secrets retirés des captures.
Mémoire, projets et fichiers d’instructions : ce qu’ils gardent
OpenAI décrit, dans l’article « Using Projects in ChatGPT », des projets qui regroupent des conversations et des fichiers ; ils acceptent aussi des instructions communes à toute l’équipe. La disponibilité de la fonction dépend de l’offre et des réglages du poste de travail. Placer la passation vérifiée parmi les fichiers d’un projet, puis ouvrir un nouveau chat dans ce même projet, évite de la ressaisir à chaque bascule.
La page « Memory FAQ » précise que la mémoire retient des préférences et du contexte général, loin du détail technique de chaque conversation : un SHA récent mérite un relevé explicite, que la mémoire ne fera pas à la place de l’équipe. Un fichier d’instructions partagé comme CLAUDE.md cadre le système prompt commun, sans certifier l’état courant d’une branche : 2 personnes qui suivent le même fichier peuvent pousser des commits différents le même jour, un des écarts entre membres d’une équipe qui suivent pourtant les mêmes instructions. Un espace de travail dédié à l’équipe aide à retrouver des documents partagés ; il ne transforme pas pour autant un résumé daté en preuve d’un commit actuel.